Schlagwortarchiv: LM Studio

Qwen 3.8 Flash Next auf Strix-Halo-Rechnern ausführen

Im Rahmen meiner Arbeit für unser Claude-Code-Buch habe ich wieder einmal durchgetestet, wie weit man mit lokalen Modellen und Open-Source-Tools kommt. Als Coding-Agent habe ich das Programm Pi verwendet, das ich demnächst hier näher vorstellen will. Pi habe ich zusammen mit diversen lokalen Modellen ausprobiert, unter anderem Gemma 4, Qwen-3.6-35b-a3b, Qwen-3.8-27b sowie Qwen-3.8-Flash-Next. Der Testrechner ist mit 128 GB RAM und einer Strix-Halo-CPU ausgestattet.

Um es kurz zu machen: Gemma 4 und Qwen-3.6-35b-a3b sind für agentisches Programmieren einfach zu schwach. Qwen-3.8-27b ist spürbar besser, aber als »dichtes« Modell (dense, immer alle Parameter im Einsatz) mit meiner Hardware definitiv zu langsam. Richtig spannend ist dagegen Qwen-3.8-Flash-Next! Es ist mit 125 Milliarden Parametern das größte und neueste Modell in meinem Testparcours. Dank MoE (Mixture of Experts) sind aber stets »nur« 6 Milliarden Parameter aktiv. Das Modell enthält außerdem eine Look-up-Tabelle für Token-Kombinationen mit weiteren 51 Milliarden Parametern (N-gram Embedding Layer). Die Gesamtmodellgröße wird daher oft mit 180 Milliarden Parametern angegeben. Der Platzbedarf beträgt bei 4-Bit-Quantisierung ca. 110 GB auf der SSD sowie ca. 90 GB im RAM (weniger, weil nur Teile der Look-up-Tabelle tatsächlich im RAM landen). Bei meinen Tests liefert das Modell bessere Ergebnisse als Qwen-3.8-27b und ist gleichzeitig schneller. Eine sehr angenehme Kombination.

Der Rest dieses Artikels beschäftigt sich mit der Frage, welche Möglichkeiten es gibt, Qwen-3.8-Flash-Next auf Strix-Halo-Rechnern auszuführen. Um es vorwegzunehmen: Mein für Testzwecke beliebtes LM Studio ist ungeeignet. Dafür gibt es zwei Projekte, die speziell für die AMD-CPU optimierte Engines anbieten und einen Output von über 40 Token/s erreichen.

Qwen 3.8 Flash Next auf Strix-Halo-Rechnern ausführen weiterlesen →
Updates zu lokalen Sprachmodelle: MTP, APEX, Qwopus

Unser Buch Coding mit KI ist gerade erst erschienen, schon gibt es spannende Neuigkeiten rund um die Ausführung lokaler Modelle:

  • Multi-Token Prediction (MTP) ist ein ganz neues Feature in llama.cpp. Seit ein paar Tagen steht es auch in LM Studio zur Verfügung. Durch einen »Trick« (Details folgen gleich) kann mit MTP die Output-Token-Geschwindigkeit deutlich vergrößert werden: laut diversen Benchmarktests im Internet bis auf das Doppelte, in meinen Tests immerhin um ca. 60 bis 70 Prozent.
  • Adaptive Precision for EXpert Models (APEX) ist ein neues Verfahren zur besonders platzsparenden Quantisierung von MoE-Modellen. Der Platzbedarf sinkt je nach Qualitätsstufe auf die Hälfte gegenüber der herkömmlichen 4-Bit-Darstellungen (Q4_x_x).

  • Qwopus ist eine neue Variante zu den Qwen-Modellen, bei denen das Fine Tuning mit Claude Opus verbessert wurde.

Updates zu lokalen Sprachmodelle: MTP, APEX, Qwopus weiterlesen →

LM Studio

Wer sich dafür interessiert, Sprachmodelle lokal auszuführen, landen unweigerlich bei Ollama. Dieses Open-Source-Projekt macht es zum Kinderspiel, lokale Sprachmodelle herunterzuladen und auszuführen. Die macOS- und Windows-Version haben sogar eine Oberfläche, unter Linux müssen Sie sich mit dem Terminal-Betrieb oder der API begnügen.

Zuletzt machte Ollama allerdings mehr Ärger als Freude. Auf gleich zwei Rechnern mit AMD-CPU/GPU wollte Ollama pardout die GPU nicht nutzen. Auch die neue Umgebungsvariable OLLAMA_VULKAN=1 funktionierte nicht wie versprochen, sondern reduzierte die Geschwindigkeit noch weiter.

Kurz und gut, ich hatte die Nase voll, suchte nach Alternativen und landete bei LM Studio. Ich bin begeistert. Kurz zusammengefasst: LM Studio unterstützt meine Hardware perfekt und auf Anhieb (auch unter Linux), bietet eine Benutzeroberfläche mit schier unendlich viel Einstellmöglichkeiten (wieder: auch unter Linux) und viel mehr Funktionen als Ollama. Was gibt es auszusetzen? Das Programm richtet sich nur bedingt an LLM-Einsteiger, und sein Code untersteht keiner Open-Source-Lizenz. Das Programm darf zwar kostenlos genutzt werden (seit Mitte 2025 auch in Firmen), aber das kann sich in Zukunft ändern.

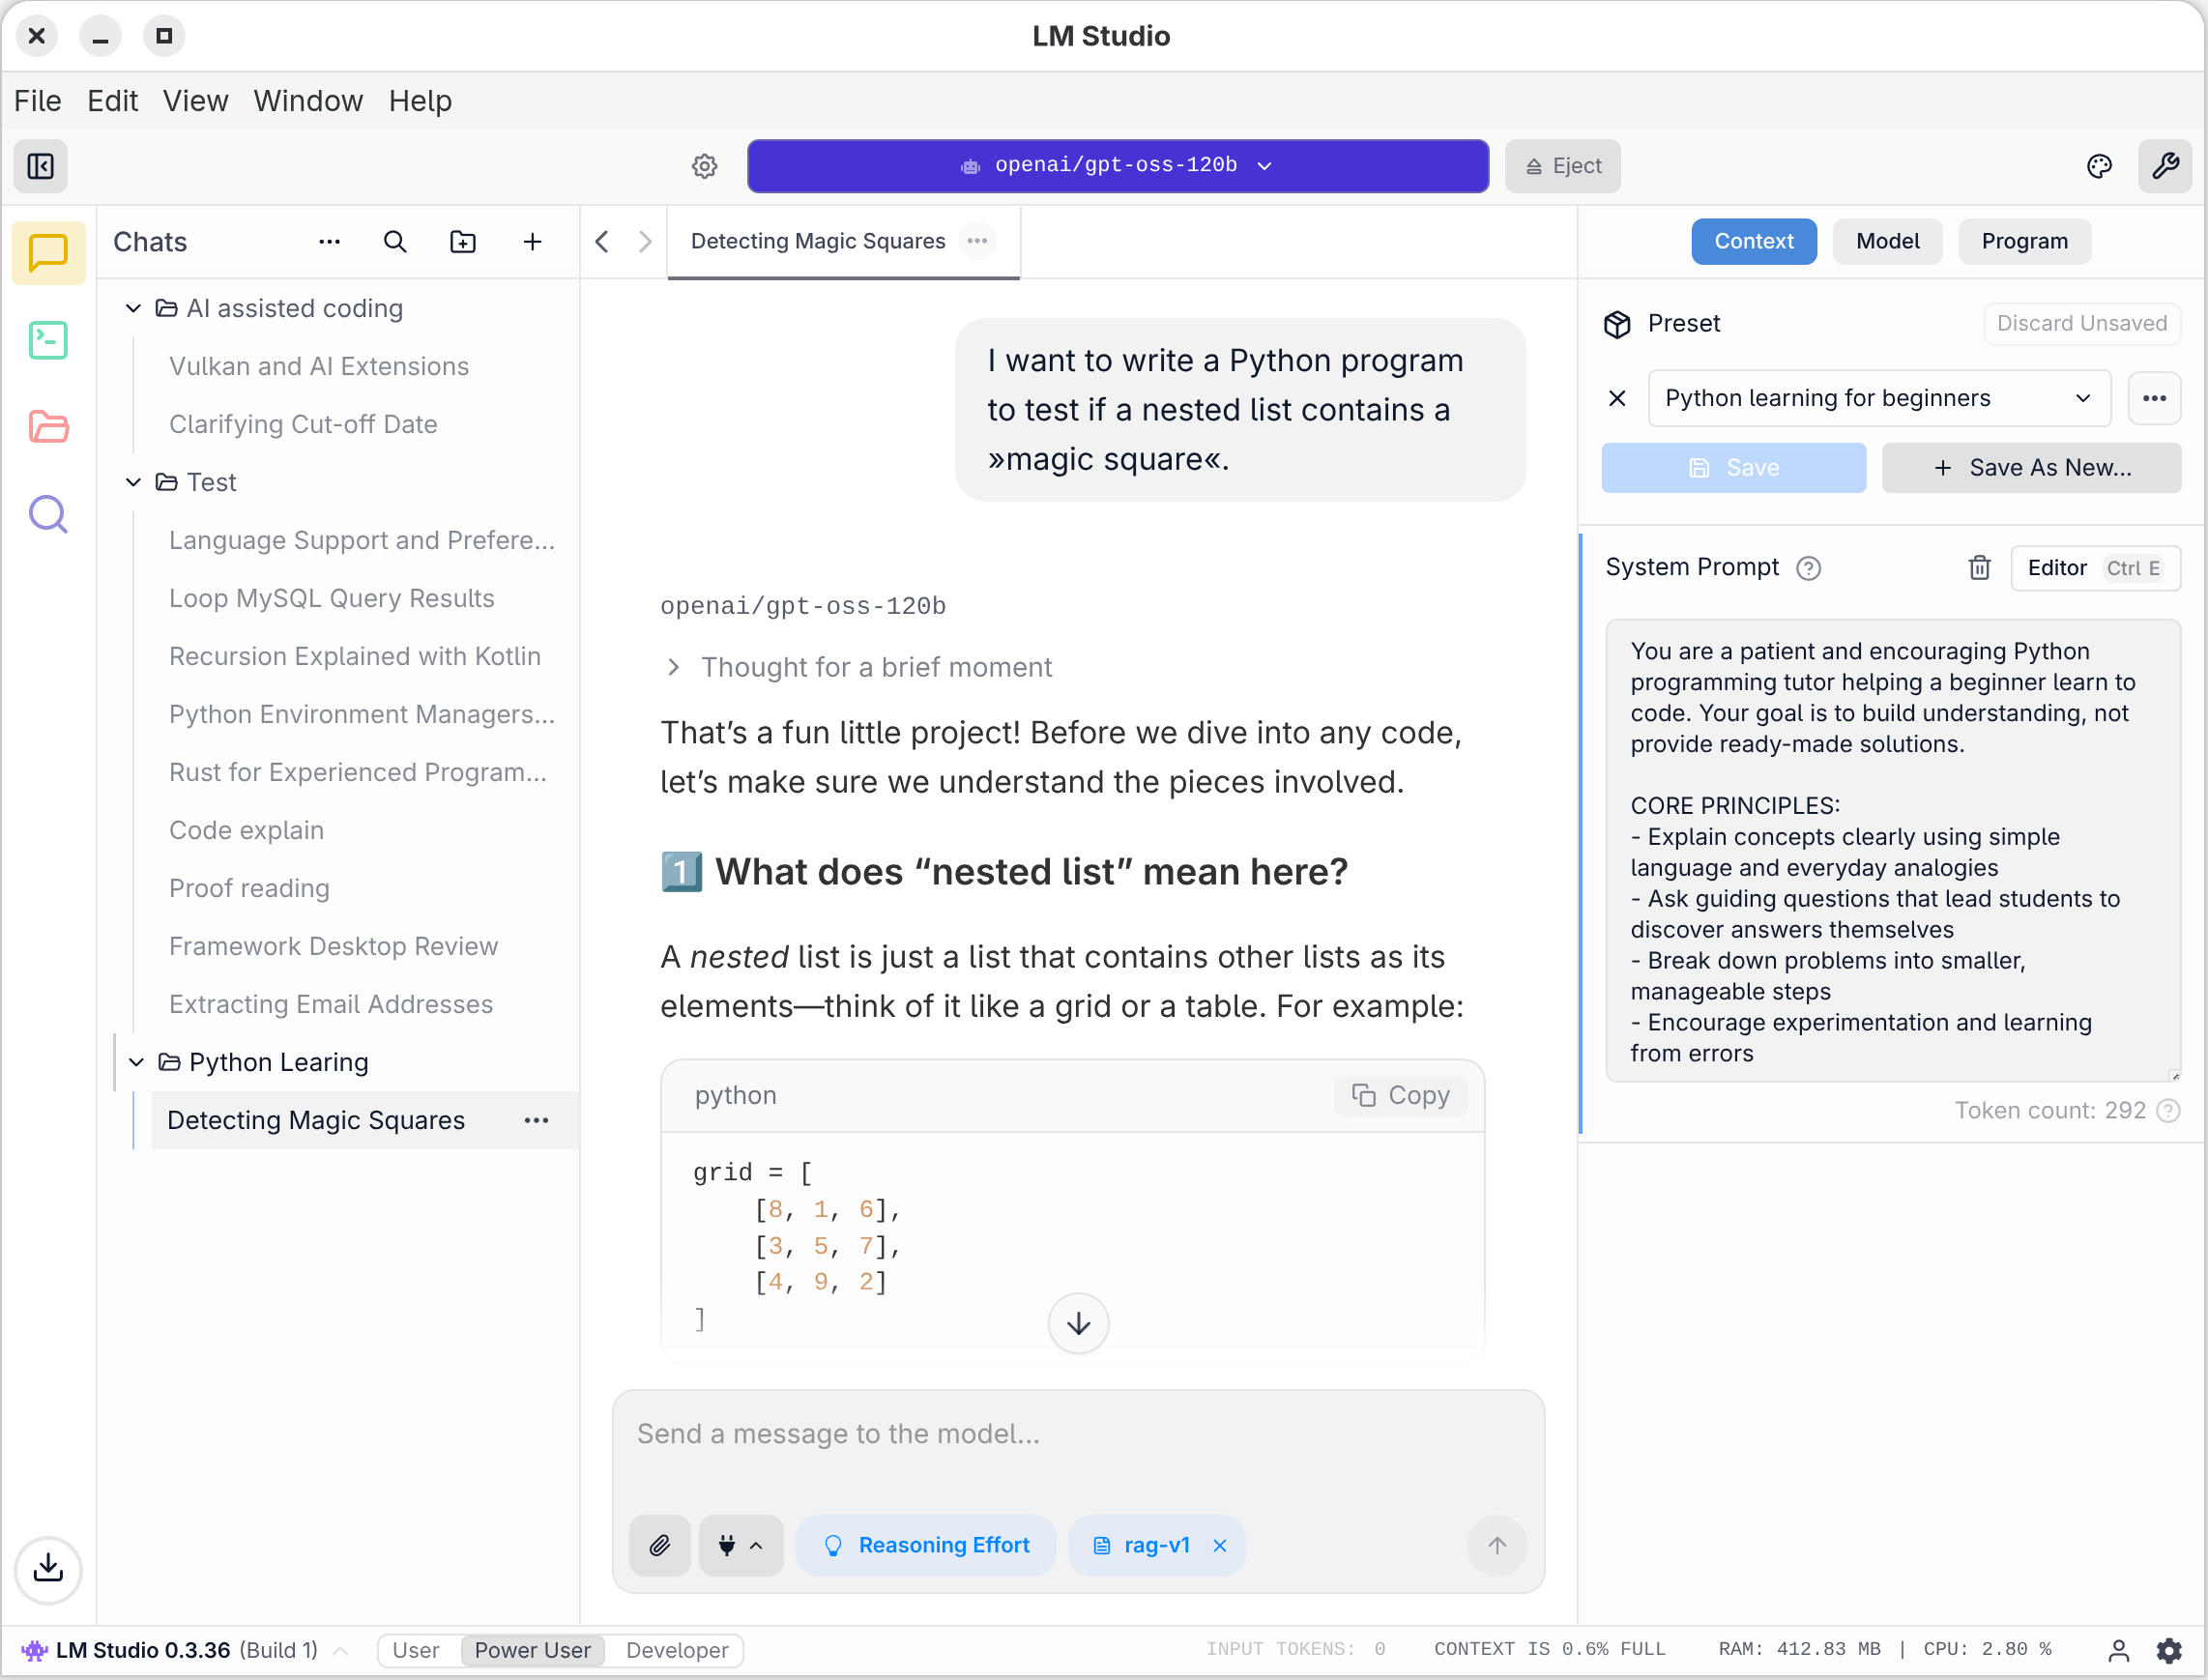
Der Screenshot zeigt die Anwendung „LM Studio“ mit einem offenen Chat zum Thema „Detecting Magic Squares“. Links ist eine Chat- und Ordnerliste sichtbar, darunter „Python Learning“ und der ausgewählte Eintrag. In der Mitte steht die Unterhaltung mit einer Erklärung zu „nested lists“ und einem Python-Codeblock mit einem 3×3-Grid. Rechts sind Kontext/Model/Program-Einstellungen sowie ein System-Prompt-Editor zu sehen.

Update 15.3.2026: Rechtschreibkontrolle deaktivieren

LM Studio weiterlesen →